AWS CLI v2 en Ubuntu: instalar, configurar y empezar con S3
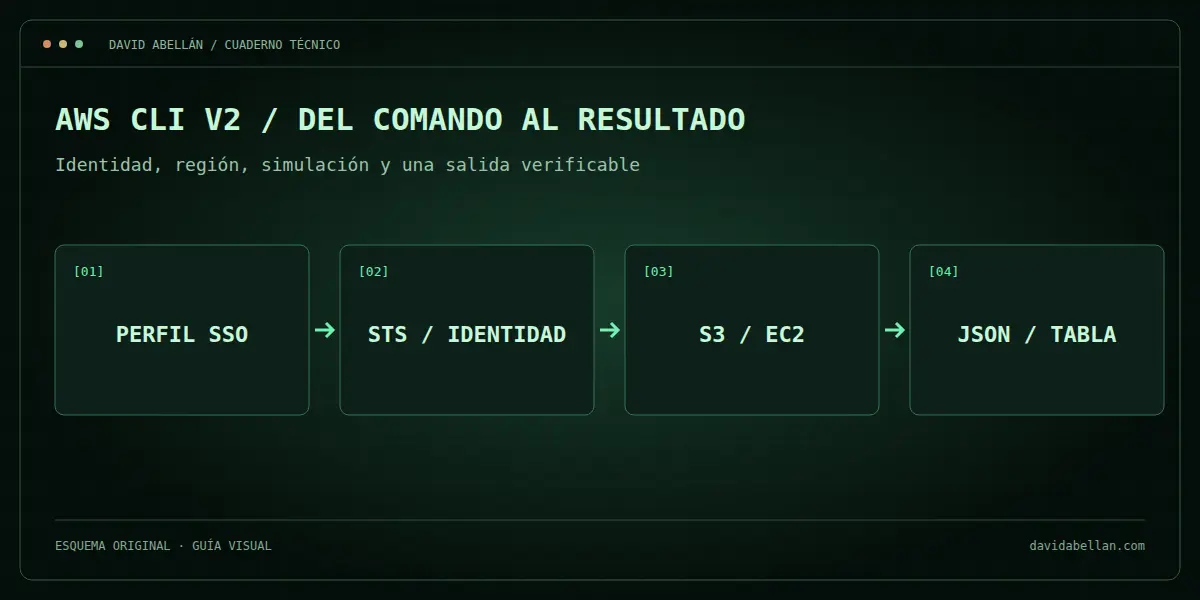
La consola web de AWS sirve para explorar, pero en cuanto repito una operación prefiero convertirla en un comando que pueda revisar y documentar. AWS CLI v2 permite consultar recursos, mover archivos a S3 y automatizar tareas desde Ubuntu sin construir una aplicación completa.
Voy a instalar la versión oficial, configurar un perfil y probar operaciones de lectura antes de tocar nada. Los nombres de cuenta, región, bucket y perfil son ejemplos: hay que sustituirlos por los propios.
Instalar AWS CLI v2 en Ubuntu x86-64
sudo apt update
sudo apt install curl unzip

curl -fsSL "https://awscli.amazonaws.com/awscli-exe-linux-x86_64.zip" \
  -o awscliv2.zip
unzip -q awscliv2.zip
sudo ./aws/install

aws --version
command -v aws
En una máquina ARM64 cambio la URL por awscli-exe-linux-aarch64.zip. No confundo el paquete antiguo que pueda ofrecer una distribución con AWS CLI v2: la salida de aws --version debe empezar por aws-cli/2.
Cuando termine puedo retirar el ZIP y el directorio extraído:
rm -f awscliv2.zip
rm -rf ./aws
Estos nombres son concretos y están en el directorio actual. Antes de cualquier borrado compruebo dónde estoy con pwd y ls.
Autenticarse sin pegar claves eternas por todas partes
Para una persona, AWS recomienda credenciales temporales y permite configurar IAM Identity Center:
aws configure sso --profile laboratorio
aws sso login --profile laboratorio
aws sts get-caller-identity --profile laboratorio
La última orden responde qué identidad está usando realmente el perfil. La ejecuto antes de una tarea delicada; evita descubrir demasiado tarde que estaba operando en otra cuenta.
En una instancia EC2 prefiero un rol asociado a la instancia con los permisos mínimos necesarios. Guardar una clave de acceso permanente en ~/.aws/credentials funciona, pero crea un secreto que hay que custodiar, rotar y retirar. Nunca incluyo credenciales en un script o repositorio.
Elegir región y formato
aws configure set region eu-west-1 --profile laboratorio
aws configure set output json --profile laboratorio
aws configure list --profile laboratorio
La región no es decorativa. Muchos recursos existen en una región concreta y una lista vacía puede significar simplemente que estamos mirando en otra.
Primeras operaciones con S3
aws s3 ls --profile laboratorio
aws s3 ls s3://mi-bucket/archivo/ --profile laboratorio

aws s3 cp informe.tar.zst s3://mi-bucket/copias/ \
  --profile laboratorio

aws s3 cp s3://mi-bucket/copias/informe.tar.zst ./restaurado.tar.zst \
  --profile laboratorio
Después de subir verifico tamaño, fecha y, para copias importantes, el contenido restaurado. Que el comando termine con éxito no prueba que hayamos subido el archivo correcto.
Sincronizar con simulación previa
aws s3 sync /srv/archivo/ s3://mi-bucket/archivo/ \
  --dryrun --profile laboratorio

aws s3 sync /srv/archivo/ s3://mi-bucket/archivo/ \
  --profile laboratorio
sync copia archivos nuevos o modificados. Solo borra en destino si añadimos --delete; esa opción merece una simulación, una revisión y una estrategia de versiones en el bucket. Sin versionado, un error automatizado puede convertirse en una pérdida automatizada.
Obtener resultados que se puedan leer
aws ec2 describe-instances \
  --profile laboratorio \
  --query 'Reservations[].Instances[].{Id:InstanceId,Estado:State.Name,Tipo:InstanceType}' \
  --output table
--query filtra la respuesta en el cliente y --output table la vuelve cómoda para una inspección humana. Para automatización mantengo JSON y trato los errores de salida; no analizo una tabla dibujada con espacios.
Actualizar la instalación
Descargo de nuevo el instalador de la arquitectura correcta y ejecuto:
sudo ./aws/install --bin-dir /usr/local/bin \
  --install-dir /usr/local/aws-cli --update
aws --version
Mi secuencia mínima queda así: instalar desde el origen oficial, usar un perfil con credenciales temporales, confirmar identidad y región, probar primero lecturas y utilizar --dryrun cuando una operación vaya a afectar muchos objetos.
Referencias: documentación oficial para instalar AWS CLI v2, configurar IAM Identity Center y usar los comandos de S3.
0 comentarios
Sé concreto, añade contexto (versión, distro, stack) y si puedes pega logs en bloque de código. Menos drama, más señales.